Gosto de usar IA para melhorar o trabalho do time. Mas preciso acompanhar o que acontece depois: a revisão que se acumula, o feedback que perde contexto e a dificuldade de explicar o que foi entregue.
Uma segunda-feira possível
A liderança pede mais velocidade. O time abriu mais PRs. O revisor passou a manhã tentando entender uma mudança grande. Na conversa de 1:1, alguém diz que está entregando mais, mas já não sabe explicar tudo o que colocou em produção.
Essa cena é ilustrativa. Ela reúne dificuldades presentes nas coletas: custo de revisão, cobrança por atividade, perda de contexto no feedback, aprendizado insuficiente e responsabilidade pouco definida. Os relatos locais ajudam a formular perguntas; seus percentuais e depoimentos compostos não são tratados aqui como pesquisa comprovada.
Eu começaria conversando com o time para entender essas dificuldades. Quando alguém diz “a IA está ajudando”, quero saber em qual tarefa, o que melhorou e quem consegue investigar a solução quando ela falha.
O DORA 2025 descreve a IA como amplificadora das forças e fragilidades da organização. Isso reforça a necessidade de olhar para o processo em que a ferramenta entrou.
Quando a ferramenta ocupa o lugar do julgamento
| Escolha de gestão | Falha que pode aparecer | Conversa que está faltando |
|---|---|---|
| Premiar prompts, commits ou código gerado | Mais atividade, fila de review e retrabalho invisível. | O cliente recebeu algo melhor? Quanto custou validar? |
| Entregar feedback escrito pela IA sem confronto | Generalizações, contexto perdido e fatos inventados. | Que situação concreta sustenta o feedback? Como a pessoa a viveu? |
| Tratar aprovação automática como garantia | Risco de regra de negócio e segurança sem dono. | Quem verificou a hipótese de falha e pode explicar a decisão? |
| Automatizar toda conversa e gravação | Exposição desnecessária e menos espaço para dúvidas. | O que vale registrar? O que os participantes querem compartilhar? |
| Cobrar o sinal vermelho antes de investigar | Alerta vira culpa; falha de coleta vira diagnóstico. | Os dados estão completos? Qual impedimento o gestor pode remover? |
São modos de falha a investigar no seu contexto, sem presumir que estejam ocorrendo em toda equipe. Simon Willison defende que a entrega inclua evidências de funcionamento e responsabilidade humana. A revisão entre colegas precisa partir desse compromisso.
O que os gauges mostram agora
Os campos foram preenchidos com resultados publicados quando havia uma referência relacionada ao tema. Há médias de teste e de produtividade autorrelatada, além de proporções de respostas. Cada painel informa qual medida está exibindo, fonte, população e limite.
Esses números não são notas de humanização. Não existe uma média validada dos quatro critérios específicos que criamos para cada prática. Eles ficam no detalhe “Controle local”, com indicação de coleta necessária. N/D significa ausência de média comparável na revisão, não zero.
Não calculamos uma média entre pesquisas: perguntas, métodos e populações são diferentes. O gauge de duas médias (50% / 67%) não recebe um preenchimento único, porque isso esconderia a comparação.
A IA ajuda quando as pessoas participam do desenho
As propostas abaixo combinam referências atuais com as dificuldades das coletas. Ethan Mollick propõe aproximar liderança, experimentação e quem faz o trabalho. Esse é um bom ponto de partida para o piloto.
Antes de pedir velocidade, entender o trabalho
O gestor recebe uma meta de adoção de IA. O time, porém, precisa resolver integrações antigas, regras pouco documentadas e revisões acumuladas. Antes de pedir mais velocidade, eu procuraria entender onde o trabalho está esperando e o que vale a pena acelerar.
Como conduzir. Eu escolheria uma jornada junto com Produto e com quem a opera. A partir daí, combinaria o resultado esperado, os riscos e quem acompanha o piloto. Na comparação entre tarefas, incluiria também o tempo de revisão.
Ferramentas que ajudam. Plugin: pacote interno de gestão de engenharia, proposto. Skill: diagnóstico de fluxo, proposta. Conectores: Jira ou Linear, documentação autorizada e métricas do serviço. Plugin é opcional; fontes e responsáveis são essenciais.
Indicadores de controle. Resultado de cliente, tempo de ideia até valor e esforço total de revisão/correção.
Prompt para Claude: Antes de pedir velocidade, entender o trabalho
Leia [objetivo, backlog e baseline]. Mostre onde o trabalho espera e quais decisões estão sem responsável. Separe evidência de hipótese. Antes de propor automação, formule três perguntas para Produto e para o time. Sugira um piloto reversível, sem mudar metas ou enviar mensagens.
Referência externa do tema
Este resultado não é um score de humanização.Pesquisa interna da Anthropic: ganho de produtividade declarado, não resultado auditado do piloto.
Limite. Não comprova participação do time, aceite de Produto ou benefício na sua equipe.
Controle local: quatro critérios sem média publicada
- Time participou da escolha do problema Coleta local necessária; sem média publicada comparável.
- Produto validou o resultado esperado Coleta local necessária; sem média publicada comparável.
- Limites e responsável foram acordados Coleta local necessária; sem média publicada comparável.
- Piloto foi revisto com quem executou Coleta local necessária; sem média publicada comparável.
Quem usa IA precisa conseguir explicar a entrega
Uma pessoa termina a tarefa cedo, mas tem dificuldade para explicar a regra de negócio ou investigar uma falha. Esse é um ponto que eu levaria para a conversa: o que ela entendeu da solução e onde precisa de apoio?
Como conduzir. Vale combinar o uso de IA com explicação da solução, testes e trabalho em dupla. A investigação pode começar pelas hipóteses da própria pessoa, antes de consultar a ferramenta. O desafio precisa fazer sentido para o momento de desenvolvimento dela.
Ferramentas que ajudam. Plugin: Code Review no Claude Code como segunda leitura. Skill: explicação e plano de testes, proposta. Conectores: GitHub/GitLab e CI/CD. Mentoria e ambiente de teste continuam necessários.
Indicadores de controle. Espera por revisão e recorrência de retrabalho no serviço; evidências qualitativas de autonomia no plano individual.
Prompt para Claude: Quem usa IA precisa conseguir explicar a entrega
Com [diff e testes], ajude o autor a entender a solução. Primeiro faça perguntas sobre regra, alternativa e caso de falha. Depois compare as respostas com o código e indique lacunas. Não escreva uma avaliação da pessoa. Gere um exercício pequeno de investigação e critérios de verificação.
Referência externa do tema
Este resultado não é um score de humanização.Experimento com aprendizagem da biblioteca Python Trio. Diferença de 17 pontos percentuais no quiz.
Limite. Não é nota de profissionais nem média geral de aprendizagem com IA. O ganho de tempo não foi estatisticamente significativo.
Controle local: quatro critérios sem média publicada
- Autor explicou a decisão em suas palavras Coleta local necessária; sem média publicada comparável.
- Autor demonstrou teste e caso de falha Coleta local necessária; sem média publicada comparável.
- Revisor discutiu uma alternativa Coleta local necessária; sem média publicada comparável.
- Houve prática de aprendizado acordada Coleta local necessária; sem média publicada comparável.
O feedback precisa chegar com contexto
Uma síntese automática pode parecer impecável e ainda perder o que importa: a pessoa que segurou uma dependência, ajudou um colega ou deixou de discordar para evitar exposição.
Como conduzir. Eu prepararia o feedback com uma situação concreta e ouviria como a pessoa viveu aquilo. Se faltou contexto, precisamos ajustar o registro. A IA pode ajudar a organizar as notas que os dois decidiram compartilhar.
Ferramentas que ajudam. Plugin: nenhum obrigatório para o 1:1. Skill: pauta e acordos de desenvolvimento, proposta. Conectores: calendário e pasta privada de notas, opcionais. Entrada manual de notas autorizadas é suficiente.
Indicadores de controle. Acordos revistos no prazo e impedimentos tratados; sem nota automática de desempenho.
Prompt para Claude: O feedback precisa chegar com contexto
Use apenas [notas autorizadas e acordos anteriores]. Sugira perguntas abertas sobre impedimentos, aprendizado e apoio. Não deduza intenção ou sentimento. Preserve divergências. Após a conversa, organize somente acordos explícitos em ação, dono, prazo e revisão, para validação dos dois.
Referência externa do tema
Este resultado não é um score de humanização.Usuários de agentes que concordaram que eles melhoraram a colaboração da equipe.
Limite. É proporção de respostas, não média de qualidade do 1:1. Não mede escuta, privacidade ou validação dos acordos.
Controle local: quatro critérios sem média publicada
- Pessoa escolheu o que compartilhar Coleta local necessária; sem média publicada comparável.
- Gestor ouviu e registrou contexto Coleta local necessária; sem média publicada comparável.
- Ambos validaram os acordos Coleta local necessária; sem média publicada comparável.
- Apoio do gestor tem ação e prazo Coleta local necessária; sem média publicada comparável.
O gestor precisa cuidar da fila e das decisões
Quando a geração acelera, quero entender com o time onde a validação ficou concentrada. Cabe ao gestor combinar critérios de entrega, proteger tempo de revisão e acompanhar o que foi decidido sobre os desvios. Tech Lead, especialistas e SRE precisam saber quais decisões estão sob sua responsabilidade.
Code review começa antes de abrir o PR
Quando a IA produz uma mudança grande, o custo pode aparecer na agenda de quem revisa. Quem abre o PR precisa trazer evidências de que a solução funciona, para que o colega consiga fazer uma revisão útil.
Como conduzir. Minha recomendação é combinar PRs pequenos, intenção explícita, evidência de teste e plano de reversão. Isso dá ao revisor condições de discutir a regra, o risco e a manutenção. Os achados da IA precisam ser confirmados antes de virarem correção ou comentário público.
Ferramentas que ajudam. Plugin: Code Review, verificado no catálogo do Claude Code. Skill: review orientado a risco, proposta. Conectores: GitHub MCP ou API GitLab, CI/CD e requisitos. O plugin pode publicar comentários; habilite escrita somente com escopo e fluxo definidos.
Indicadores de controle. Espera p75 por revisão, retrabalho e falhas de mudança; interpretar volume e criticidade.
Prompt para Claude: Code review começa antes de abrir o PR
Revise [diff], [requisitos] e [testes]. Para cada achado, cite arquivo/linha, condição de falha, impacto e forma de reproduzir. Diferencie bug confirmado de hipótese. Identifique dúvidas para o autor. Não aprove, faça merge ou publique comentários. Devolva uma revisão para validação humana.
Referência externa do tema
Este resultado não é um score de humanização.Respondentes que citaram esse problema no uso de ferramentas de IA.
Limite. Não é taxa de bugs nem percentual de PRs defeituosos. Sustenta atenção à verificação, não cumprimento dos critérios locais.
Controle local: quatro critérios sem média publicada
- Autor forneceu intenção e testes Coleta local necessária; sem média publicada comparável.
- Revisor confirmou achados relevantes Coleta local necessária; sem média publicada comparável.
- Responsável validou riscos e rollback Coleta local necessária; sem média publicada comparável.
- Autor compreendeu a correção Coleta local necessária; sem média publicada comparável.
Um teste verde precisa dizer o que foi protegido
Quando a mesma IA escreve o código e os testes, eu procuraria entender quais regras foram verificadas. Uma falha pode fazer o cliente perder dinheiro ou repetir uma operação, mesmo com os testes passando.
Como conduzir. Derive testes do requisito e do risco. Para pagamentos e eventos, inclua duplicidade, idempotência, falha parcial e recuperação quando aplicáveis. Gates bloqueiam a entrega quando uma verificação obrigatória falha.
Ferramentas que ajudam. Plugin: Playwright MCP para testes de interface em ambiente autorizado, quando houver interface. Skill: estratégia de testes e prontidão de deploy, proposta. Conectores: CI/CD, requisitos e resultados de segurança. Playwright não substitui testes de contrato, integração ou regras financeiras.
Indicadores de controle. Defeitos escapados, falhas de mudança, retrabalho de deploy e recuperação de deploy com falha.
Prompt para Claude: Um teste verde precisa dizer o que foi protegido
Leia [regras, arquitetura e casos existentes]. Identifique cenários críticos ausentes, inclusive falhas e recuperação. Proponha testes independentes da implementação, critério de aceite e evidência exigida para deploy. Não alegue que um teste passou sem execução registrada. Não execute em produção.
Referência externa do tema
Este resultado não é um score de humanização.Respondentes que declararam desconfiar da precisão das saídas de IA no trabalho de desenvolvimento.
Limite. Não mede segurança do código, efetividade de testes ou taxa de falha.
Controle local: quatro critérios sem média publicada
- Dono do domínio validou cenários críticos Coleta local necessária; sem média publicada comparável.
- Há evidência de execução dos testes Coleta local necessária; sem média publicada comparável.
- Revisor verificou limites dos testes Coleta local necessária; sem média publicada comparável.
- Exceções têm justificativa e dono Coleta local necessária; sem média publicada comparável.
O alerta deve abrir uma investigação, não uma cobrança
O painel fica vermelho. Antes de cobrar uma resposta, eu olharia com o time para o que mudou: um deploy, a demanda ou até a integração que coleta os dados.
Como conduzir. Falhas operacionais e tendências precisam de encaminhamentos diferentes. As regras devem ser determinísticas, os dados precisam estar reconciliados e cada rota deve ter um responsável. Claude pode resumir as evidências e as dúvidas. Na reunião semanal, eu combinaria com o time um impedimento que possamos remover.
Ferramentas que ajudam. Plugin: pacote interno de acompanhamento, proposto. Skills: triagem de incidentes e análise DORA, propostas. Conectores: Grafana/Datadog, PagerDuty, CI/CD e canal Slack/Teams. Agendador, armazenamento e motor de regras completam a operação.
Indicadores de controle. SLO, cinco métricas DORA, atualização da coleta e alertas que tiveram ação útil.
Prompt para Claude: O alerta deve abrir uma investigação, não uma cobrança
Use [snapshot calculado e política]. Confira atualização e completude. Resuma somente alertas disparados, com serviço, regra, n/N, fonte, impacto e dono. Liste hipóteses alternativas e a próxima verificação. Não atribua culpa, crie incidentes ou envie mensagens. Recomende uma ação para o gestor remover um impedimento.
Referência externa do tema
Este resultado não é um score de humanização.Respondentes do DORA 2025 com pouca ou nenhuma confiança no código gerado por IA.
Limite. Não é frequência de alerta ou falha; pergunta e população diferem do Stack Overflow.
Controle local: quatro critérios sem média publicada
- Alerta tem evidência e responsável Coleta local necessária; sem média publicada comparável.
- Time participou da análise do contexto Coleta local necessária; sem média publicada comparável.
- Ação remove impedimento identificado Coleta local necessária; sem média publicada comparável.
- Resultado foi revisto com o time Coleta local necessária; sem média publicada comparável.
| Sinal | Condição proposta | Responsável e primeira ação |
|---|---|---|
| Coleta indisponível | Mais de 2h sem sucesso numa coleta horária. | Dono dos dados verifica a integração; painel fica insuficiente. |
| Fila de validação | Espera p75 por review > 1,3× baseline por duas semanas; n ≥ 20 PRs elegíveis. | Tech Lead verifica tamanho das mudanças, capacidade e dependências. |
| Falhas de mudança | Taxa > baseline + 5 pontos percentuais; ≥ 20 deploys em 28 dias. | SRE/EM investigam causas; incidentes críticos seguem o plantão. |
| Qualidade obrigatória | Gate de teste ou segurança exigido falhou. | Autor e revisor tratam o bloqueio antes da entrega. |
Limites propostos, sem valor de benchmark. Ajuste ao baseline; baseline zero exige limite absoluto. Alerta inclui regra, serviço, janela, fonte, amostra e dono. Notifique abertura, mudança de severidade e resolução, evitando duplicidade.
- Dados confiáveis
- Verificação
- Decisão humana
- Ação com dono
- Revisão
KPIs que merecem entrar na conversa
| Pergunta de gestão | Indicador | Como interpretar |
|---|---|---|
| O trabalho melhorou algo para o cliente? | Conversão, conclusão da jornada ou tempo de resolução. | Escolher com Produto um resultado e segmento por serviço. |
| Qual é o custo de entregar esse resultado? | Custo por sucesso e custo total do piloto. | Incluir licença, infraestrutura, revisão e correção. |
| Estamos entregando com estabilidade? | As cinco métricas DORA e SLO. | Comparar o mesmo serviço; mostrar janela, n/N e completude. |
| Onde o fluxo está esperando? | Espera p75 por review e itens bloqueados. | Discutir capacidade, dependências e tamanho das mudanças. |
| As pessoas estão ganhando autonomia? | Evidências de prática e acordos de desenvolvimento revistos. | Conversa privada e contextual, sem score de pessoa. |
As cinco métricas DORA atuais: frequência de implantação, lead time de mudança, tempo de recuperação de deploy com falha, taxa de falha de mudança e taxa de retrabalho de deploy. Lead time começa no commit; tempo de ideia até valor é um indicador separado.
O que instalar, o que ensinar e o que conectar
Prompt orienta a tarefa atual. Skill ensina um procedimento reutilizável com critérios e exemplos. Conector dá acesso a uma fonte ou ação. Plugin reúne capacidades para um trabalho. A configuração varia entre Claude, Cowork e Claude Code; confirme superfície, plano e permissões.
O plugin Code Review é um exemplo existente para Claude Code. As skills de diagnóstico, aprendizado, 1:1 e triagem mencionadas acima são propostas específicas deste método; não estão instaladas. Elas devem ser versionadas e avaliadas antes de uso. O guia de Agent Skills explica o mecanismo.
Comece com os repositórios do piloto, CI/CD, backlog e documentação selecionada. Acrescente observabilidade, incidentes e custos quando o caso exigir. Para alertas contínuos, implemente coletor, armazenamento, regras e destino de notificações. Para 1:1, use notas autorizadas em acesso separado. A documentação dos conectores orienta a verificação das capacidades.
Um primeiro ciclo de acompanhamento
Eu começaria por um serviço, junto com quem entrega, revisa e opera. O baseline de quatro semanas pode usar histórico validado; se ele não existir, precisamos estender a coleta. No piloto, manteria os alertas em observação e combinaria review com evidências e uma prática de aprendizado por participante. O acompanhamento proposto é semanal para o fluxo, quinzenal para os acordos de 1:1 e mensal para valor e custo.
Aos 90 dias, decida com o time se o processo merece expansão, ajuste ou interrupção. A atualização do METR em 2026 mostra dificuldades de medir o ganho atual da IA. A comparação local também precisa expor limitações e evitar atribuir causalidade a um simples antes/depois.
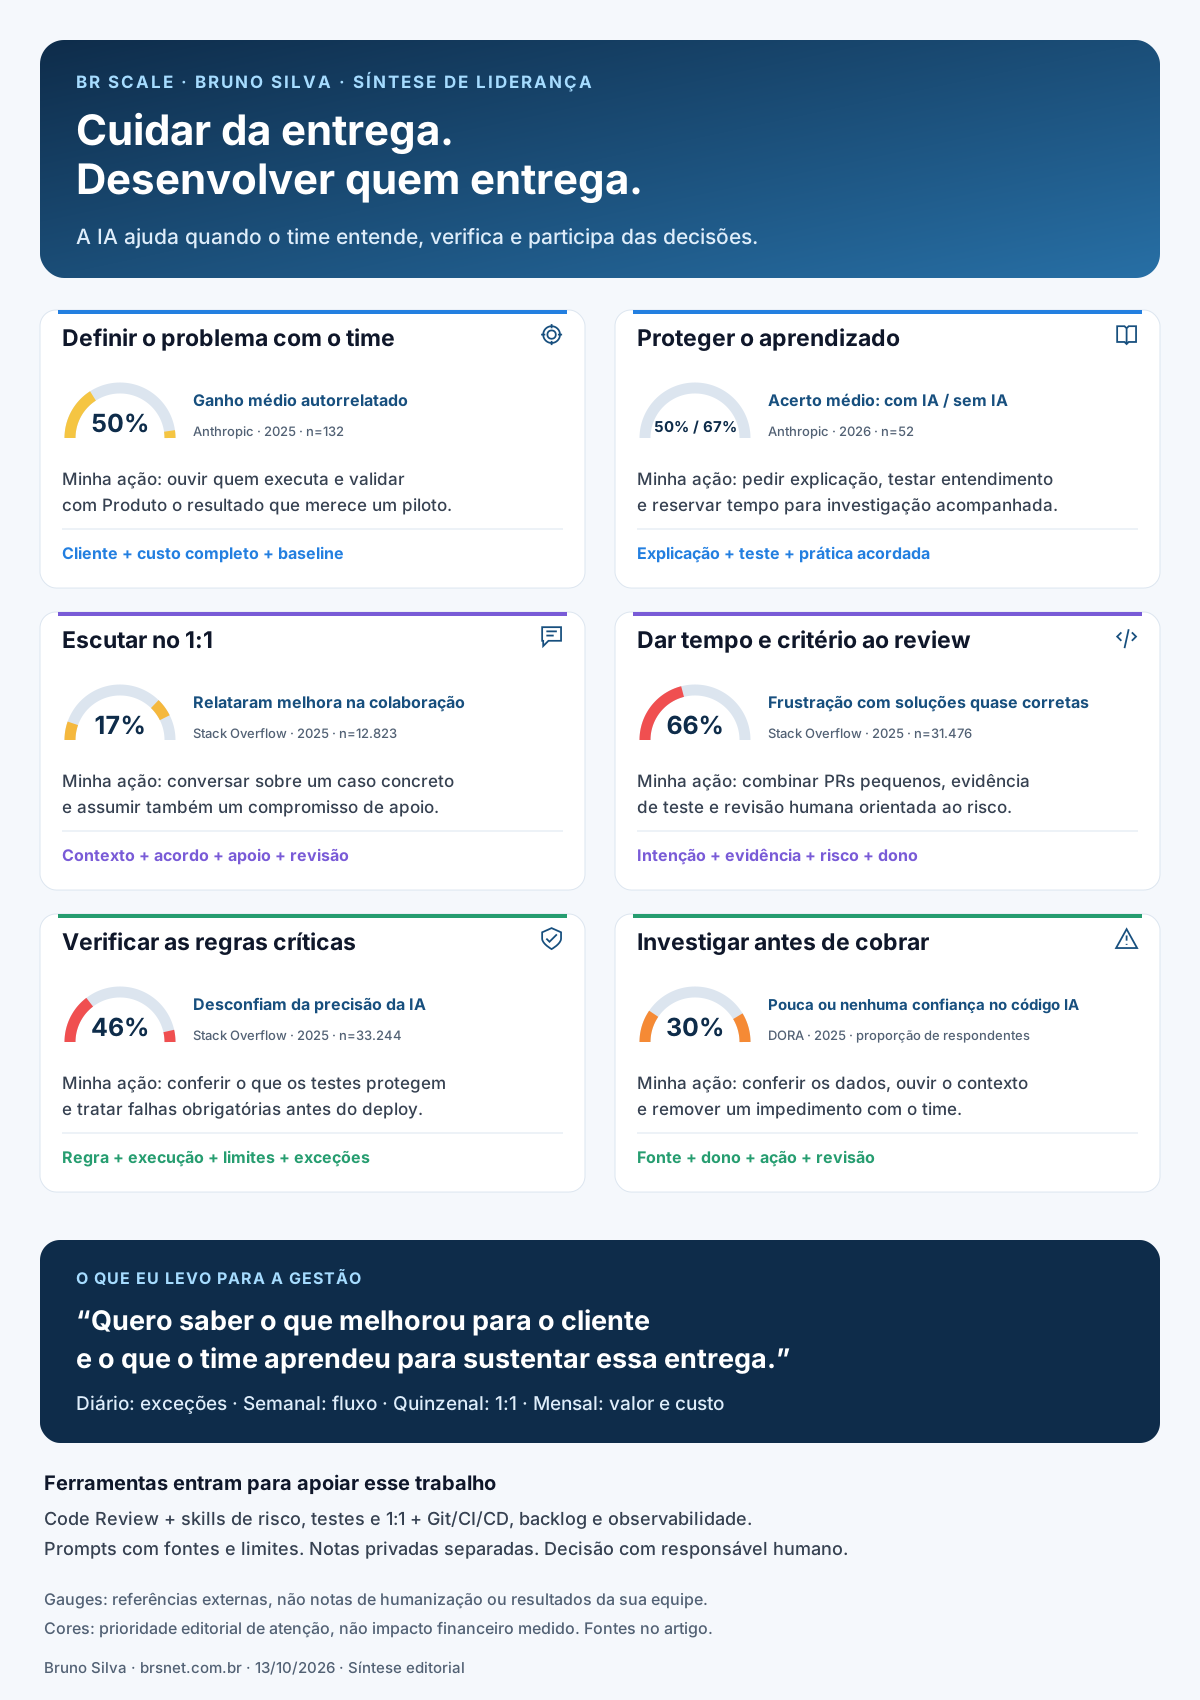
Infográfico de síntese
Quero uma entrega melhor e um time capaz de sustentá-la
Quando olho para o uso de IA no time, quero entender o que mudou no trabalho. Procuro saber se a pessoa consegue explicar a solução, se quem revisa tem tempo para conferir os riscos e se o cliente recebeu algo melhor. Essa conversa ajuda a entender onde a ferramenta contribui e o que precisamos ajustar.
No 1:1, eu levaria um caso concreto, uma dúvida que ficou sem apoio e uma habilidade que a pessoa quer desenvolver. Também assumiria uma ação: remover uma dependência, oferecer mentoria ou reservar tempo de prática. Esse desenvolvimento precisa de tempo na agenda e de acompanhamento no encontro seguinte.
Para acompanhar a entrega, eu combinaria resultado de cliente, custo completo, confiabilidade e as cinco métricas DORA. Usaria os alertas para abrir uma investigação com o time. No code review, pediria intenção, evidência de teste e entendimento da correção. Plugins, skills e conectores ajudam a organizar esse trabalho; os critérios e a responsabilidade precisam estar claros entre as pessoas.
O compromisso que eu assumo
Quero saber o que melhorou para o cliente e o que o time aprendeu para sustentar essa entrega. Se a velocidade cresceu, preciso conferir também como ficaram a revisão, o custo e a autonomia das pessoas.